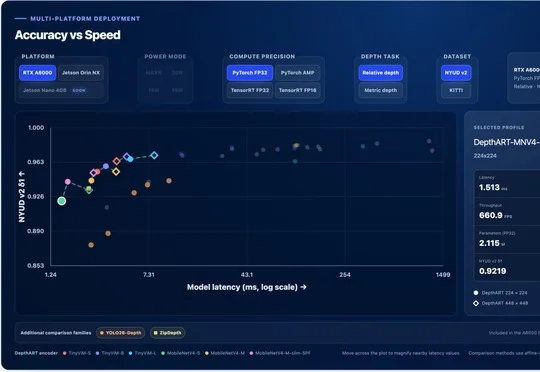
把Depth Anything砍到6M,深度估计终于能跑进Jetson
把Depth Anything砍到6M,深度估计终于能跑进Jetson论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
来自主题: AI技术研报
8121 点击 2026-10-03 10:28

 搜索
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
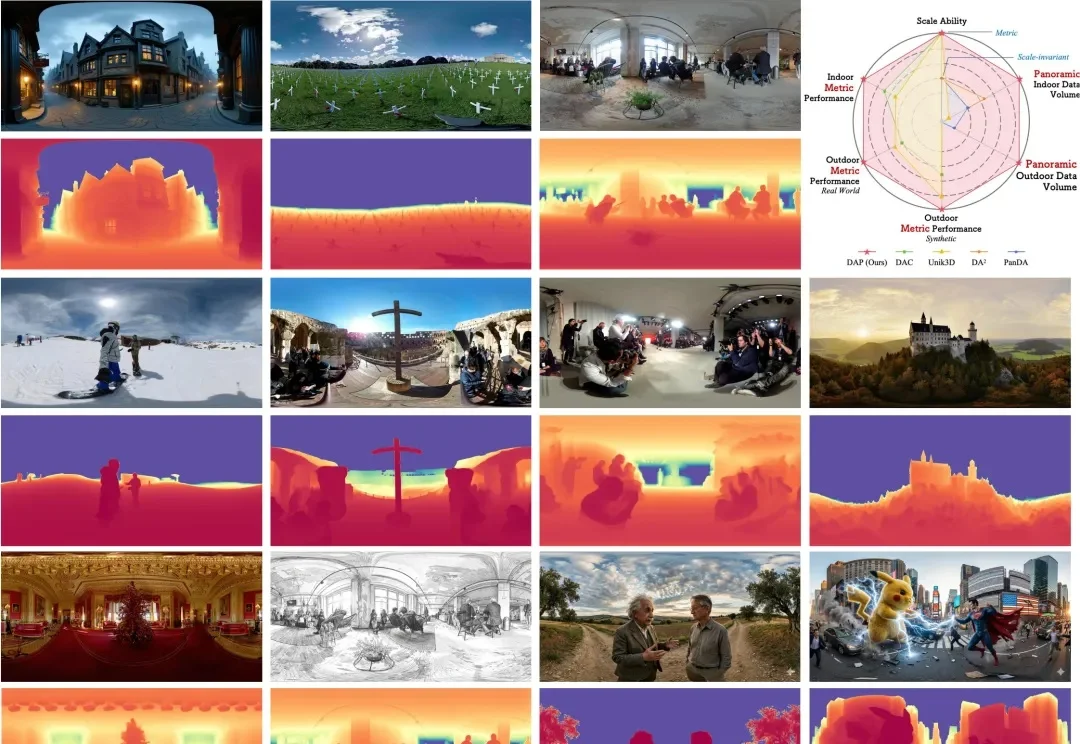
在空间智能(Spatial Intelligence)飞速发展的今天,全景视角因其 360° 的环绕覆盖能力,成为了机器人导航、自动驾驶及虚拟现实的核心基石。然而,全景深度估计长期面临 “数据荒” 与 “模型泛化差” 的瓶颈。
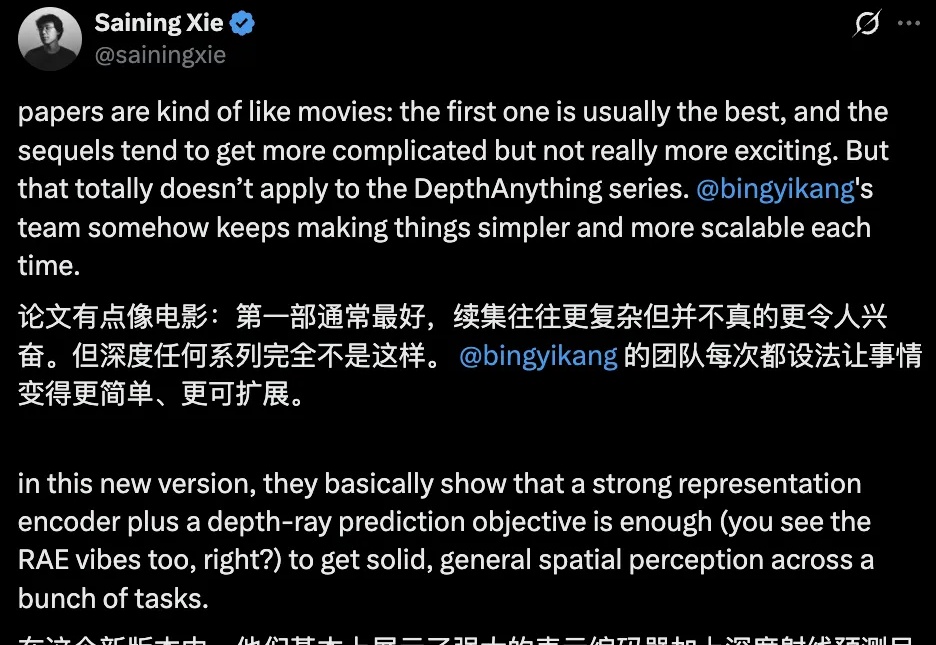
单Transformer搞定任意视图3D重建!

机器之心报道 编辑:泽南、杨文 现在,只需要一个简单的、用深度光线表示训练的 Transformer 就行了。 这项研究证明了,如今大多数 3D 视觉研究都存在过度设计的问题。 本周五,AI 社区最热
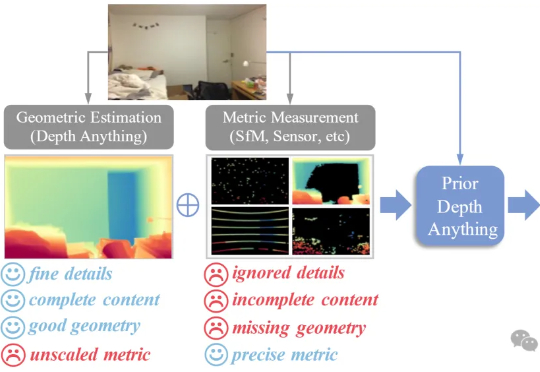
浙江大学与港大团队推出「Prior Depth Anything」,把稀疏的深度传感器数据与AI完整深度图融合,一键补洞、降噪、提分辨率,让手机、车载、AR眼镜都能实时获得精确三维视觉。无需额外训练,就能直接提升VGGT等3D模型的深度质量,零样本刷新多项深度补全、超分、修复纪录。
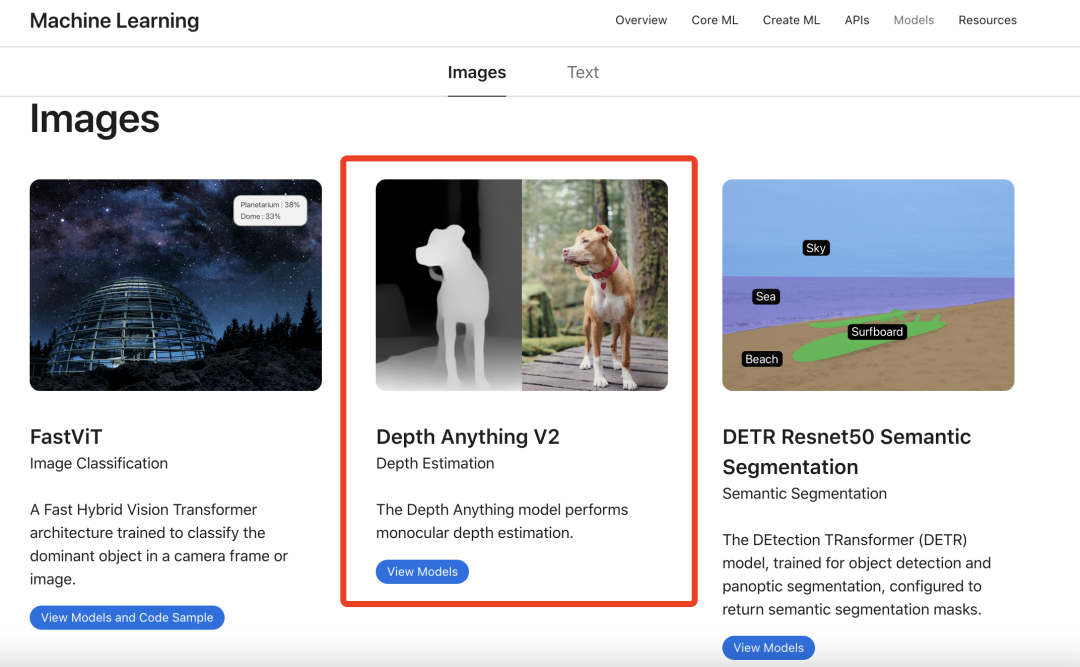
近日,字节跳动大模型团队开发的成果 Depth Anything V2 ,入选苹果公司 Core ML 模型库,目前已呈现在开发者相关页面中。
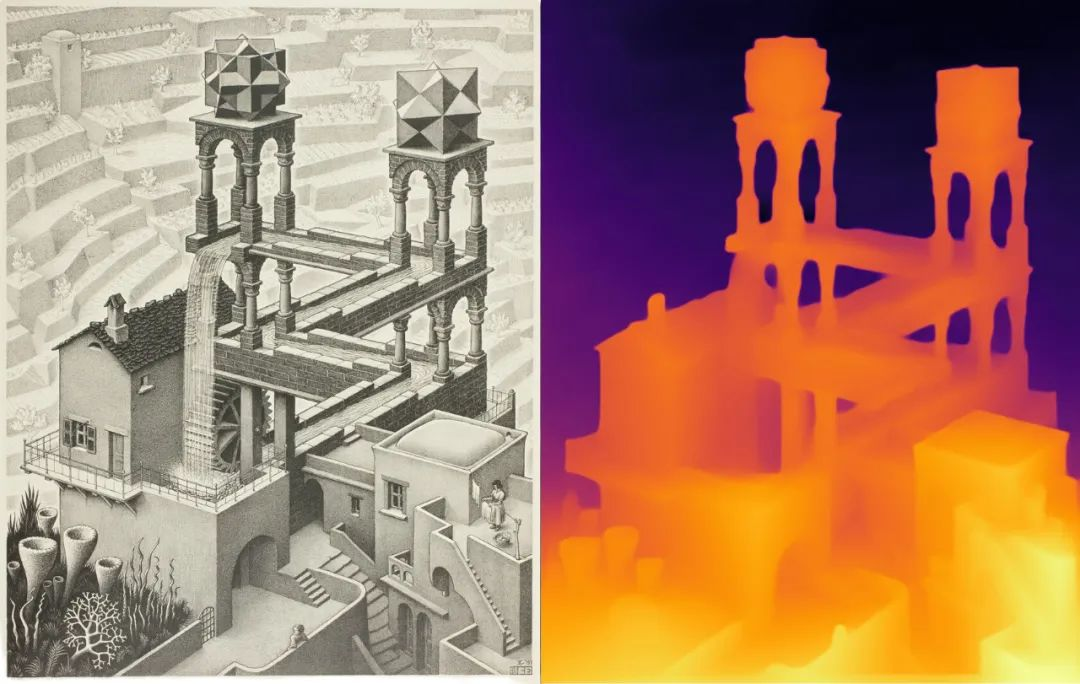
人类有两只眼睛来估计视觉环境的深度信息,但机器人和 VR 头社等设备却往往没有这样的「配置」,往往只能靠单个摄像头或单张图像来估计深度。这个任务也被称为单目深度估计(MDE)。